为什么要重写80%的代码
在过去的一年里,我们收到了大量来自用户的反馈,集中指向几个棘手的问题:多栏版式的古籍识别经常出现区域串行,大字正文和小字夹注的区分不够精准,倾斜较严重的扫描件校正效果不稳定。
这些问题看似独立,但追根溯源,都指向同一个底层原因——排版引擎的架构设计已经跟不上日益复杂的实际场景。修修补补解决不了根本问题,我们决定推倒重来。于是,80%的代码被重写。这不是一个轻松的决定,但回头看,这是唯一正确的选择。
在这次重写过程中,我们也在核心环节大量使用大模型进行辅助编程。从区域检测模块的重构,到大小字检测的分类逻辑,再到倾斜校正算法的调试,大模型都参与了算法设计、代码生成、逻辑梳理,工作效率提升显著。
区域检测模块:让多栏版式不再“串台”
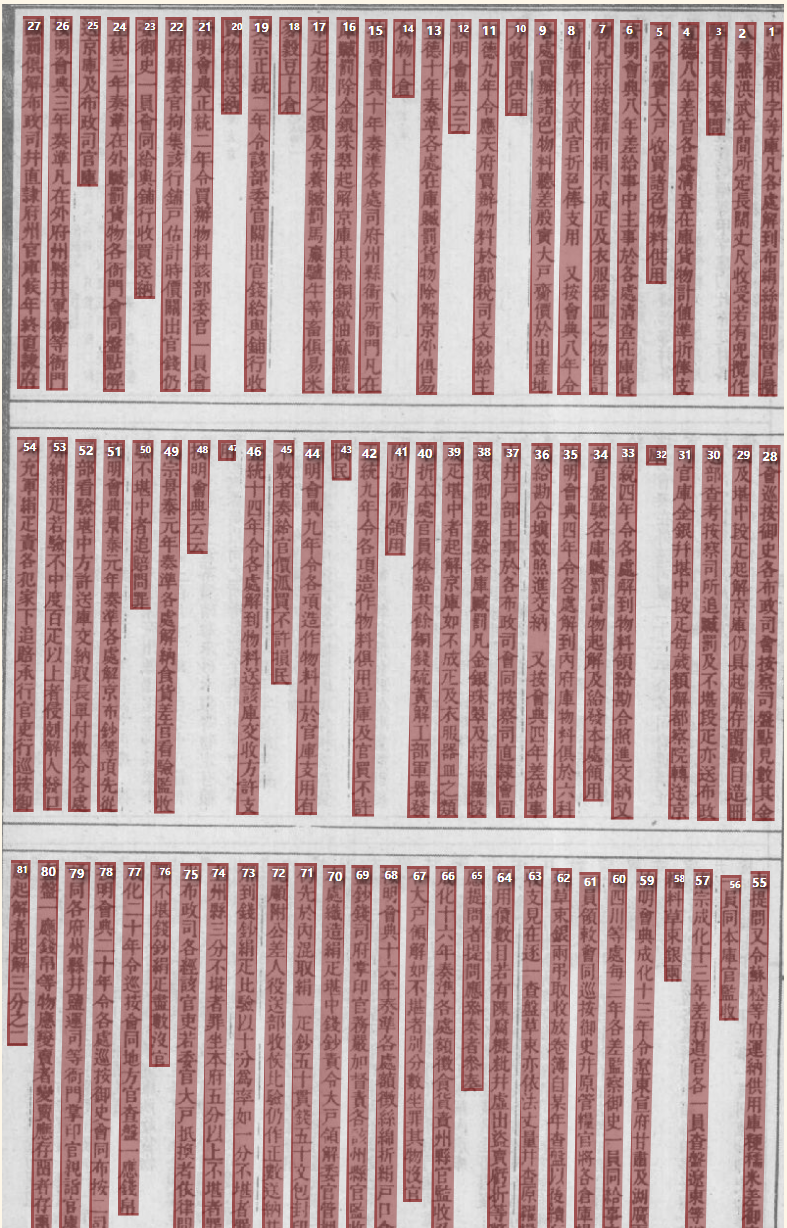
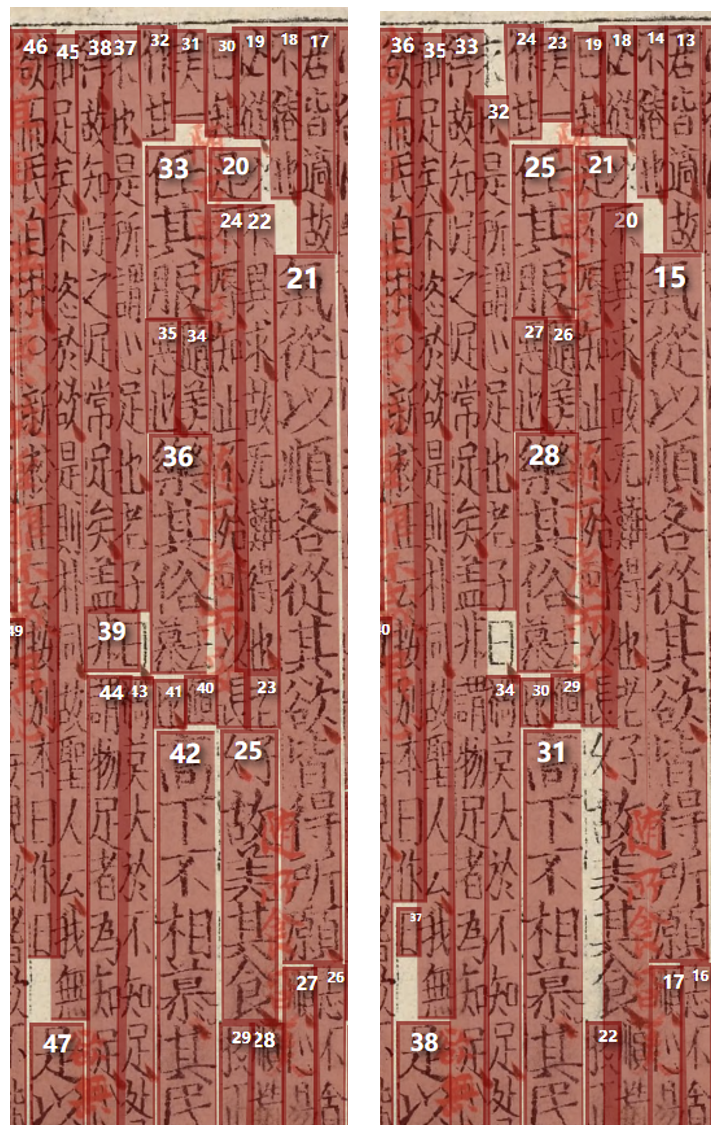
古籍中的多栏版式并不少见——双栏对照、三栏批注、图文混排,这些版式在传统排版引擎中很容易出现区域识别混乱的问题。过去,用户需要手动通过 area 参数标注每个区域的矩形坐标,稍有不慎就会导致识别顺序错乱。
排版2.0新增了区域检测模块,通过 area_ids 字段标识每个单字所属的区域序号。这意味着引擎现在能够自动识别图像中的不同区域,并将识别结果按区域组织输出。对于开发者和研究者而言,返回的结构化数据中,每个字都携带了明确的区域归属信息,后处理逻辑可以基于此做更精细的版面还原。
启用方式也很直观,通过 layout_type 参数控制:
- layout_type=2 :排版2.0,启用自动区域检测。引擎自行判断图像中的区域划分,area_ids 字段有效。
- layout_type=1 :排版2.0,不启用自动区域检测。沿用原有的 area 参数人工标注区域,area_ids 字段无效。
- layout_type=0 :排版1.0,通过 area 参数人工标注区域,area_ids 字段无效。
这套设计的好处在于向后兼容——已有的集成方案不需要改动,同时为愿意尝试新能力的用户提供了平滑的升级路径。对于多栏古籍、带有插图分割的复杂版式,自动区域检测可以显著降低人工标注的成本。
大小字检测:让夹注不再“隐身”
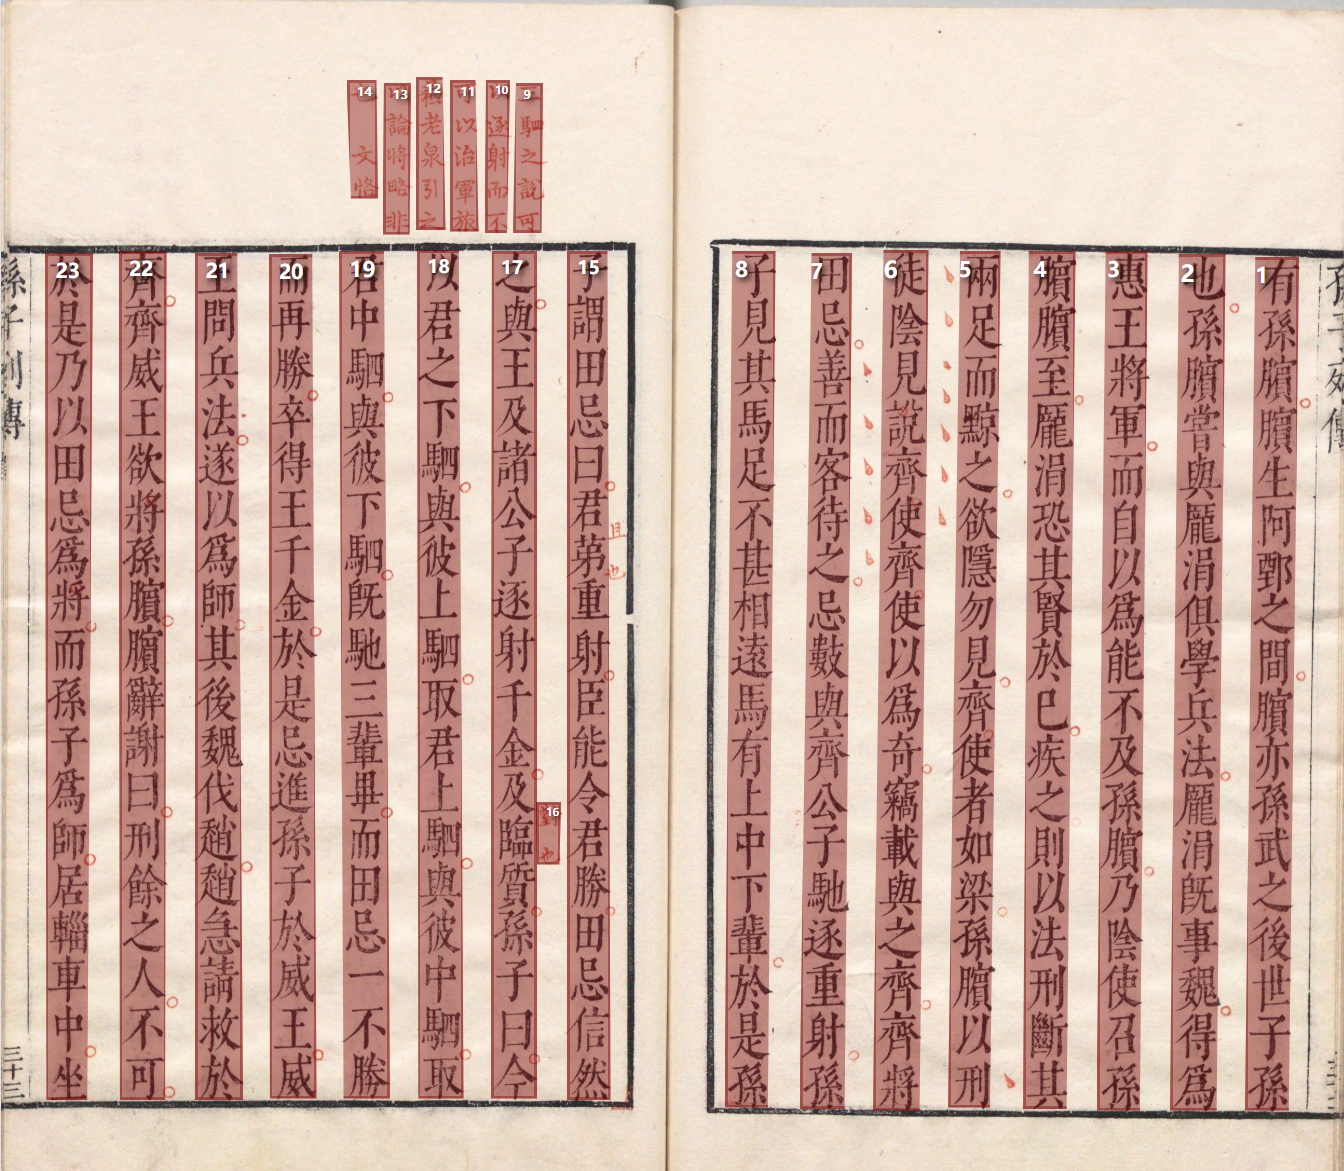
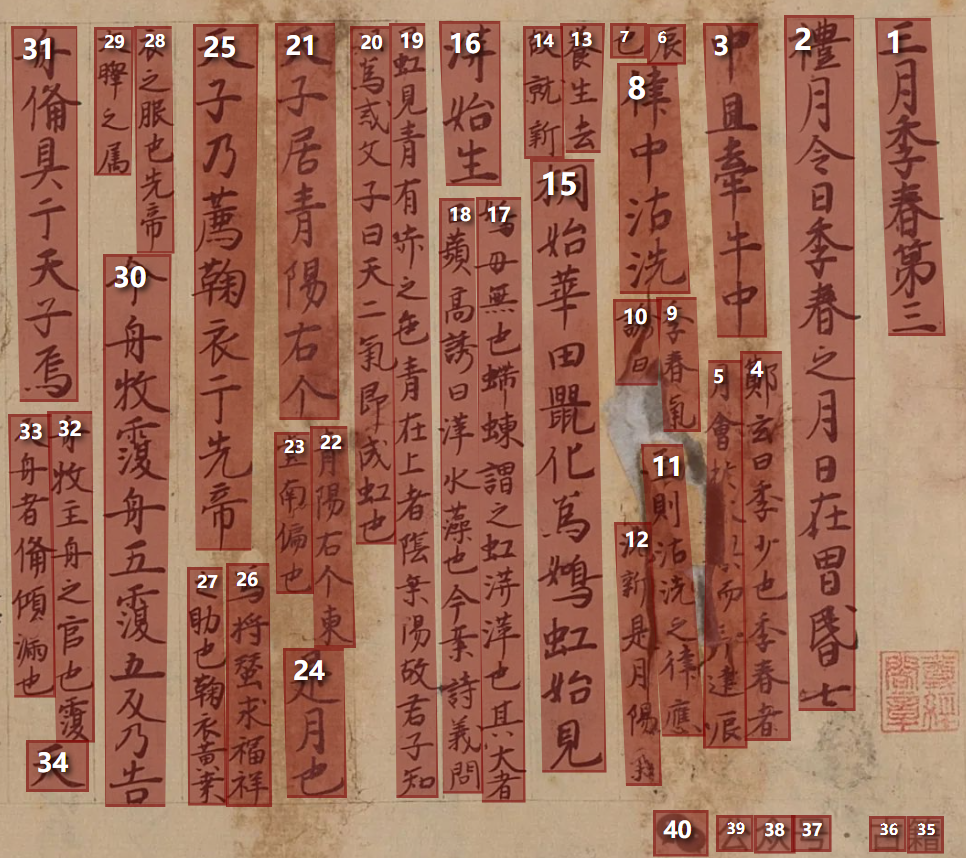
古籍中的双行夹注是一个经典难题。正文大字与夹注小字在视觉尺度上差异明显,但传统OCR流程往往一视同仁,结果要么夹注被遗漏,要么与正文混在一起。
排版2.0新增了大小字检测模块,通过 anno 字段标识每个字的大小属性。anno 是0到1之间的浮点数:0代表大字,1代表小字,越靠近0越偏向大字,越靠近1越偏向小字;中间值则反映模型对该字归属的判断置信度。开发者和研究者可以据此在输出结果中灵活区分正文与夹注。
这一模块的意义不止于识别准确率。对古籍数字化项目而言,正文与夹注的区分直接影响后续标点、翻译和知识抽取——夹注常常是理解正文的关键线索,一旦被淹没在正文里,整篇文献的语义结构就会失真。
排版1.0中,小字判断主要依赖 layer 字段:先判断某一文字列是否属于夹注,再把夹注列整体认定为小字。这种间接推断有天然局限。页眉批注、单列小字、页码等,并不属于夹注,却同样是小字;而头尾贯通的夹注列,layer 字段也难以准确描述。大小字检测直接落在单字尺度上,绕开了这些限制,也让上述情况有了更可靠的解决方式。
倾斜校正:更稳、更准
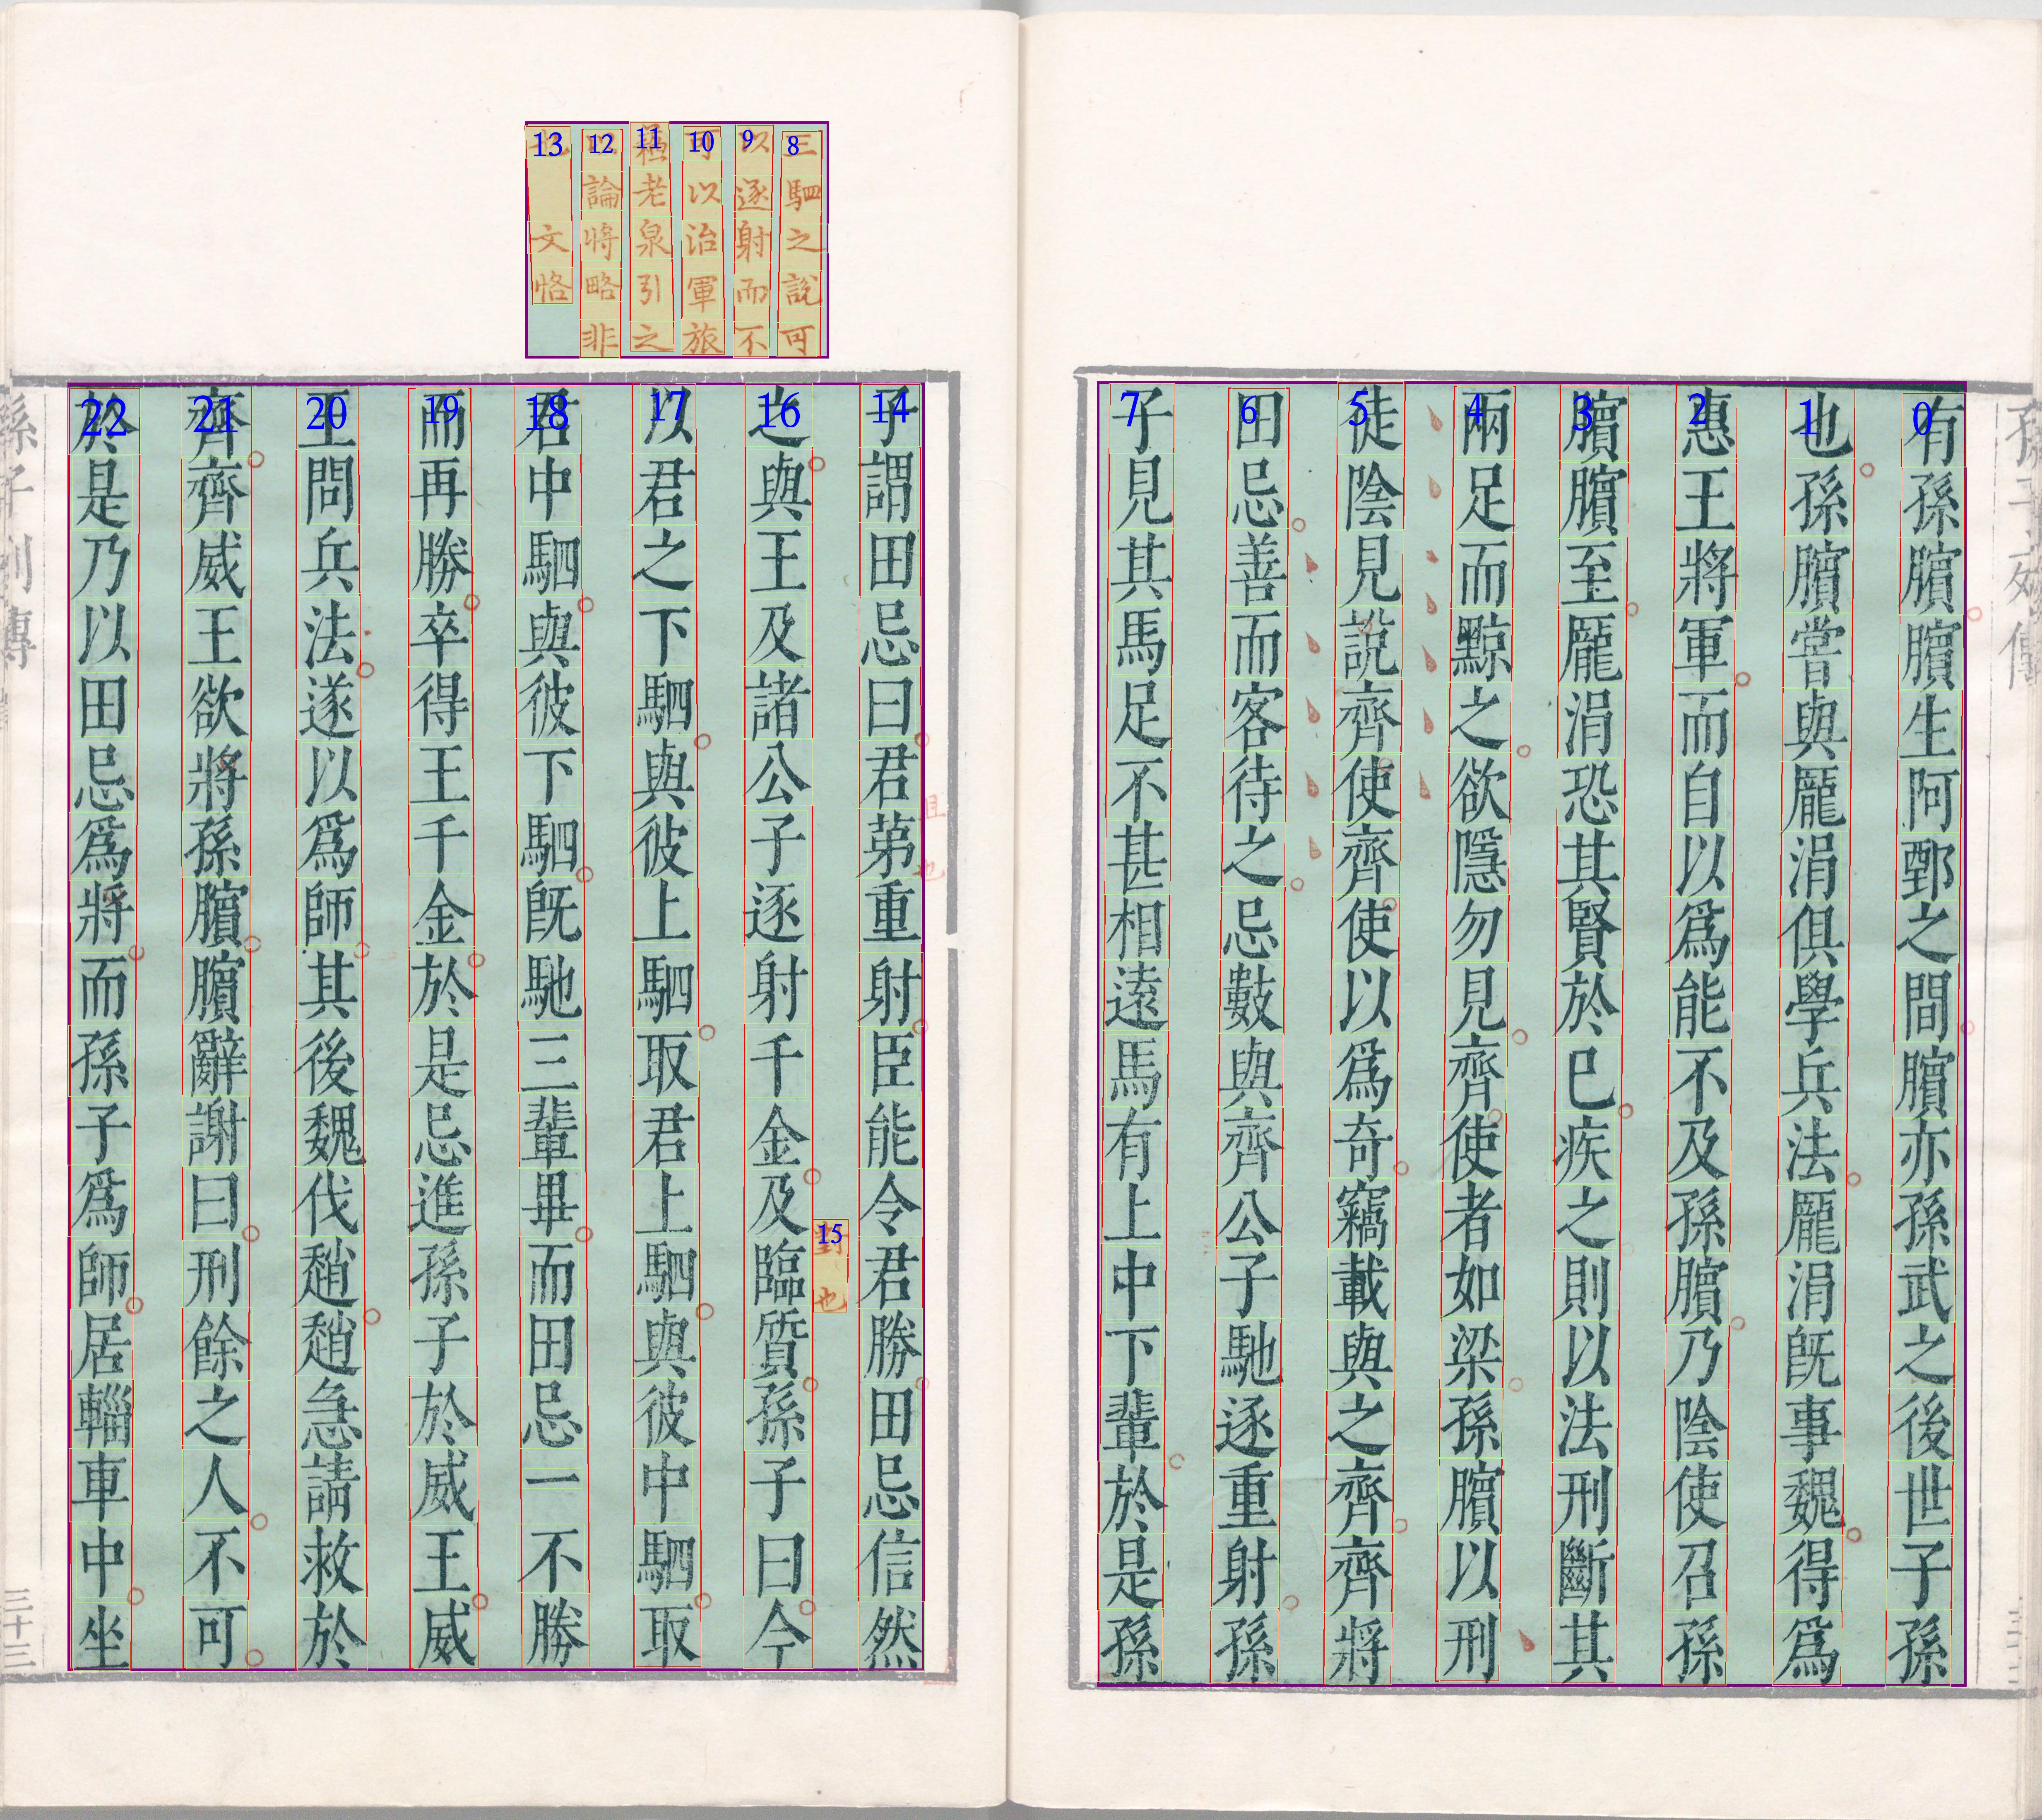
倾斜校正并不是新功能,但排版2.0中的倾斜校正模块经过了重新设计和增强。文字列排序对图像的平整程度要求很高,图像一旦明显倾斜,文字列排序就极易出错。
新的倾斜校正模块采用更鲁棒的检测策略,能够处理更大角度范围的倾斜,同时对局部变形的适应性也有明显改善。
从API的角度看变化
对于已经接入古籍酷API的开发者来说,这次更新的变化是稳健、平滑的。
新增的 layout_type 参数默认值为1:既启用了排版2.0的一些新特性,又保留了 area 参数的人工标注配置,不需要改变原有调用方式。如果想继续留在排版1.0,将 layout_type 设为0即可;如果希望体验自动区域检测,则将 layout_type 设为2,响应结果中的 area_ids 字段会携带每个字所属的区域序号。
大小字检测自动启用——每次OCR请求的返回结果中都会包含 anno 字段,无需额外参数配置。对于正在构建古籍数字化流水线的团队来说,这意味着可以在不修改现有请求逻辑的前提下,逐步将大小字信息纳入后处理流程。
接入标注平台
排版2.0的区域检测能力也接入了古籍酷的标注平台,尚处在测试阶段。用户可以在“设置 -> 自动排序 -> 检测区域”中启用这一功能。启用之后,平台在使用古籍识别、绘制、导出数据等功能时,会自动应用区域检测逻辑,同一区域内的文本列自然排序,不同区域的文本列互不干扰。对于经常处理多栏古籍、图文混排版式的用户,这个开关值得先打开试一试。
图4:启用“检测区域”功能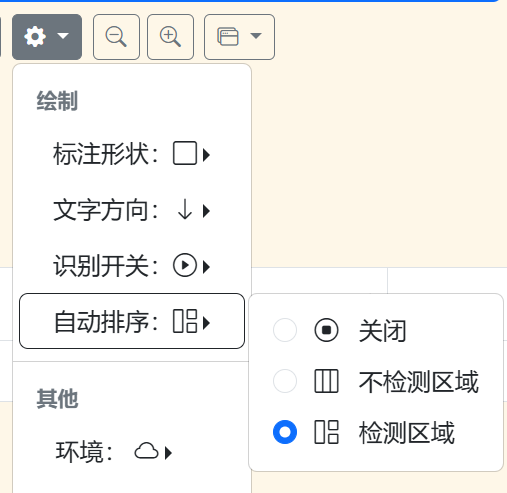
高精度版本:ocr_plus
面向准确还原异体字的专业场景,我们推出了全新 API:ocr_plus。它是 ocr_pro 的高精度升级版本,能够更细致地保留原刻、原抄中的异体字写法,而不是简单地归一化为标准字形。对于古籍整理、文字学研究、碑刻录文等需要保持字形原貌的项目,ocr_plus 提供了更可靠的识别结果。
目前该版本面向企业用户开放测试申请。有需要的团队可以通过官方渠道提交测试申请,我们会根据实际使用场景安排接入和评估。具体参数与返回格式与ocr_pro完全一致,请参考古籍酷 API 文档。
写到这里,我想起一位用户说过的话:“古籍数字化最难的不是技术,是让技术在古籍面前保持谦卑。”
这次重写,80%的代码推翻重来,区域检测、大小字识别、倾斜校正逐一打磨,过程并不轻松。但当我们看到那些原本被漏掉的夹注小字第一次被准确标出,那些倾斜的页面第一次被稳稳校正,那些多栏版式不再串行,就觉得这些功夫没有白费。技术终究是工具,古籍才是主角。